SSS Welcoming System
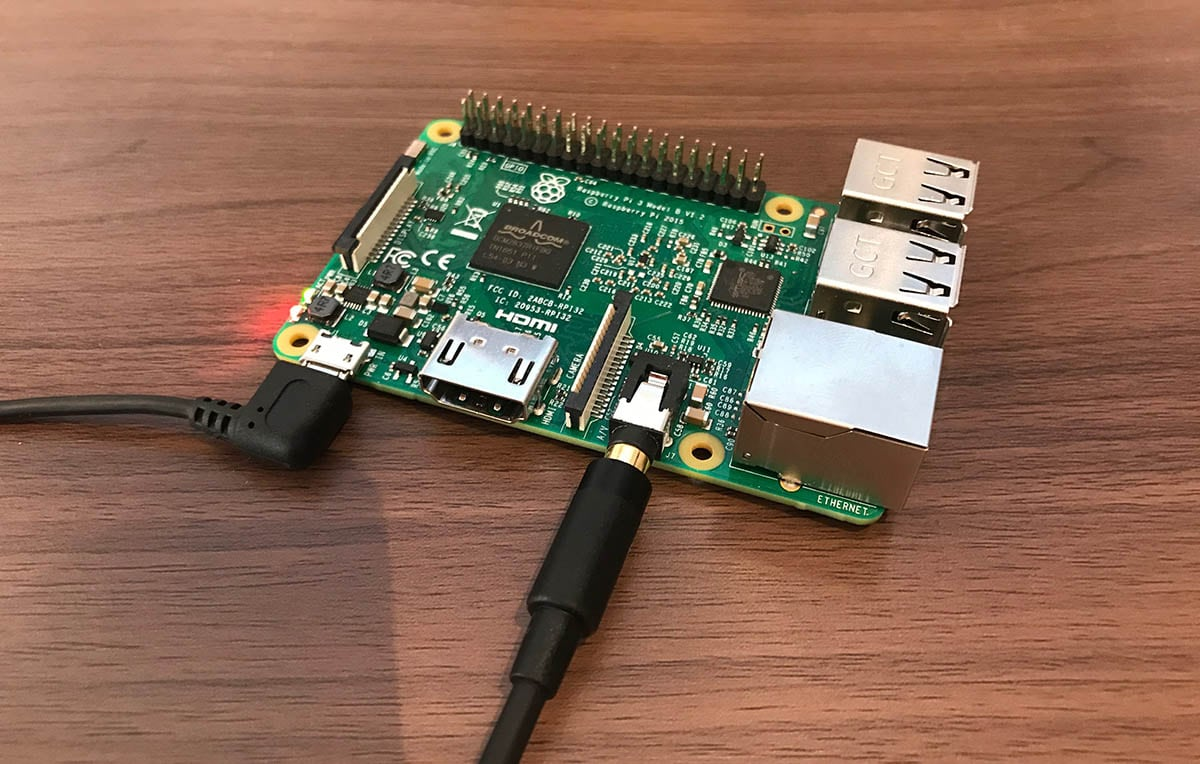


Ansiktsgjenkjenning på Raspberry Pi som hilser kunder med norsk talesyntese. Team-prosjekt på USN, karakter B.
SSS Welcoming System er en liten boks med kamera, mikro-PC og høyttaler som kjenner igjen stamkunder og sier hei på norsk når de kommer inn døra. Det var IoT-faget vårt på USN.
Problem
Valgfaget SSS3000R på USN krevde at vi bygde et IoT-system på Raspberry Pi som leste fra en sensor og gjorde noe meningsfullt med dataen. Casen måtte vi finne på selv. Vi landet på en butikk-situasjon: et kamera ved døra som kjenner igjen stamkunder og hilser dem med navn, slik at en ansatt slipper å stå klar ved inngangen.
Løsning
Et Python-system som kjører på en Raspberry Pi 4 med kameramodul og høyttaler. libcamera-vid kjører som subprosess og dumper bilder fortløpende i /run/shm/ (tmpfs i RAM, raskere enn disk). Hovedløkka leser ferskeste bilde og sender det til face_recognition, et Python-bibliotek bygget på dlib og deep learning. OpenCV tegner rødt rektangel og navn over ansiktet, og gTTS lager hilsenen "velkommen kjære kunde [navn]" som spilles av via pydub. Kjente personer er .jpg-filer i images/-mappa, og filnavnet brukes som navn i hilsenen. Vi var tre på laget fra USN, og jobbet sammen om det meste.
Beslutninger og refleksjon
Beslutninger jeg tok
Dette var teambeslutninger. Jeg var med på alle, så jeg bruker "vi" der det stemmer.
To filer i stedet for ett flatt script. En klasse, FaceRecognizer, for selve gjenkjenningen, og en hovedløkke for kamera, tegning og lyd. OOP-skillet gjorde at gjenkjenningsbiblioteket kunne byttes ut uten å røre kameradelen.
Bildet skaleres ned til 25 % før gjenkjenning. Full oppløsning (720x540) var for tregt for sanntid på Pi. Vi byttet litt presisjon mot fart, og hele forskjellen lå i én linje: frame_resizing = 0.25.
libcamera-vid som subprosess, ikke picamera2. Vi prøvde Python-veien først og brukte for mye tid på build-feil før vi snudde. Subprosess pluss shared memory ga oss lav latency uten å slite med Python-pakker som er vanskelige å bygge på Pi.
gTTS over en offline-TTS som espeak. Norsk tale fra gTTS høres vesentlig mer naturlig ut. Ulempen er at den krever internett ved kjøring, og det er en kjent svakhet.
Én last_greeted-streng for å hindre at samme person hilses i hver frame. Alternativet ville blitt spam. Slik vi løste det, hilses begge på nytt hvis to personer veksler foran kamera.
Hva jeg lærte
gTTS-kallet ligger pakket inn i try / except Exception: pass. Hvis Pi-en mister nett under kjøring, vises ansiktet med navn på skjermen, men lyden uteblir uten et eneste varsel. Stille feil er noe jeg vil unngå i kode jeg skriver i dag, i hvert fall en logglinje til stdout.
Hvis libcamera-vid selv kræsjer, så merker ikke hovedløkka det. Den fortsetter å lete etter bilder i en tom mappe. En enkel helsesjekk på subprosessen burde vært på plass, men det rakk vi aldri på et semester.
Variabelnavnene er en blanding av norsk og engelsk. Camera_start, ttrat, last_greeted. Det viser at koden vokste fram av tre personer som skrev hver sin del, og at oppryddingen aldri ble prioritert. Karakteren ble B. Jeg ville ryddet variabelnavnene før jeg leverte i dag.
Technology Stack
- Språk:Python
- Computer Vision:OpenCV, face_recognition
- Talesyntese:gTTS, pydub
- Hardware:Raspberry Pi, libcamera-vid
- Arkitektur:OOP
Key Features
- Sanntids ansiktsgjenkjenning
Identifiserer kjente ansikter i livestream fra kamera.
- Norsk talesyntese
Hilser hver person med navn på norsk via gTTS.
- Embedded-distribusjon
Kjører selvstendig på Raspberry Pi uten ekstern server.


