Prissammenligner
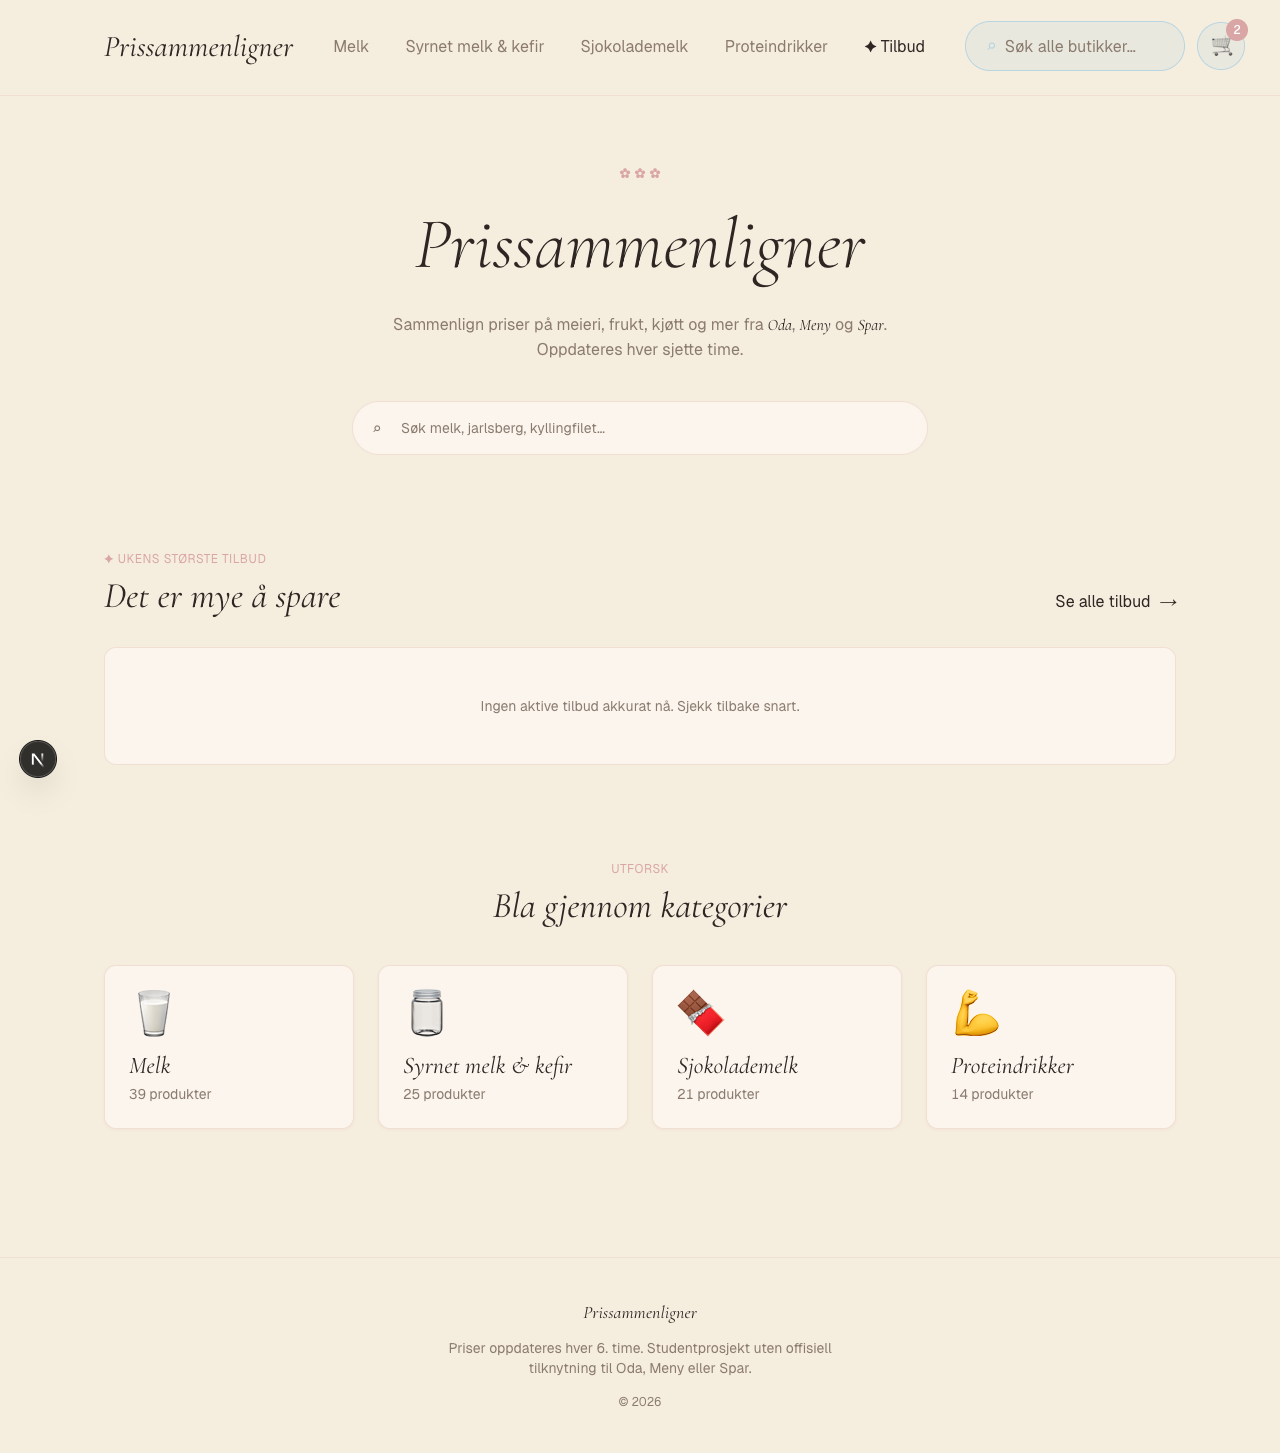
Sammenligner meieripriser fra Oda, Meny og Spar. Viser hvor du sparer mest.
Prissammenligner viser deg hvilken butikk som har billigst melk og meieriprodukter akkurat nå. Jeg bygde den fordi jeg jobber med priser til daglig og var lei av å åpne tre apper for å sammenligne.
Problem
Som alle andre sliter jeg med å huske hvilken butikk som har billigst melk og proteindrikker, og må bla i tre apper for å sjekke. Og jeg jobber jo med dette til daglig: som prisdata-innsamler hos AVANTAS (feb 2024 til nå) samler jeg inn prisdata fra butikker manuelt med skanner. Så priser har vært i hodet mitt mye mer enn vanlig. Jeg ville bygge en automatisert miniversjon av jobben for meg selv, og se hvor langt jeg kom uten skanneren.
Løsning
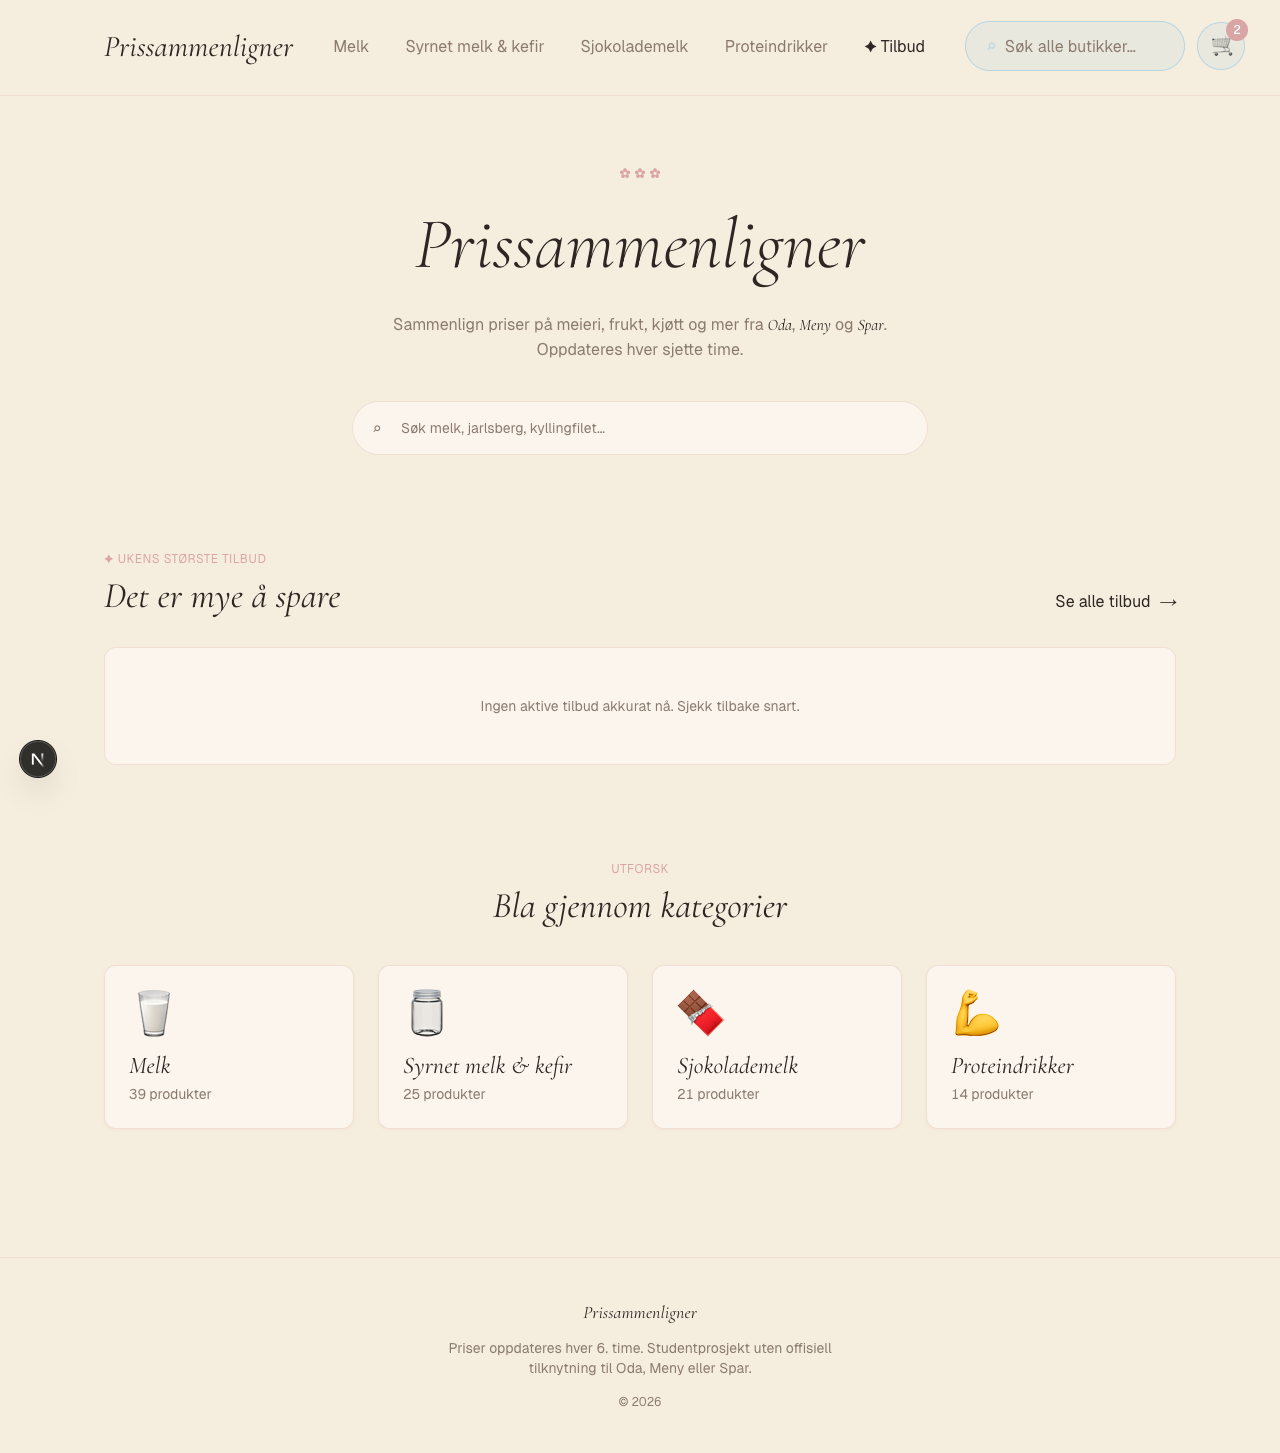
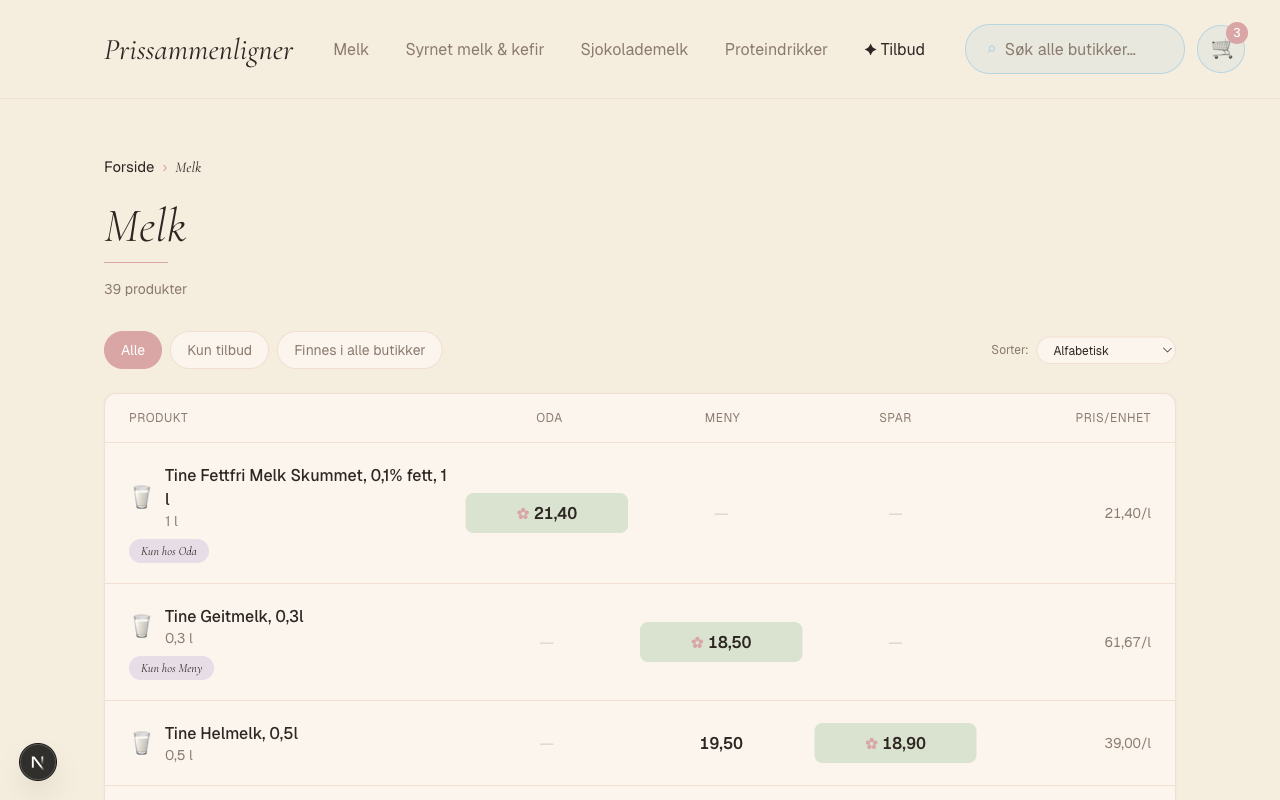
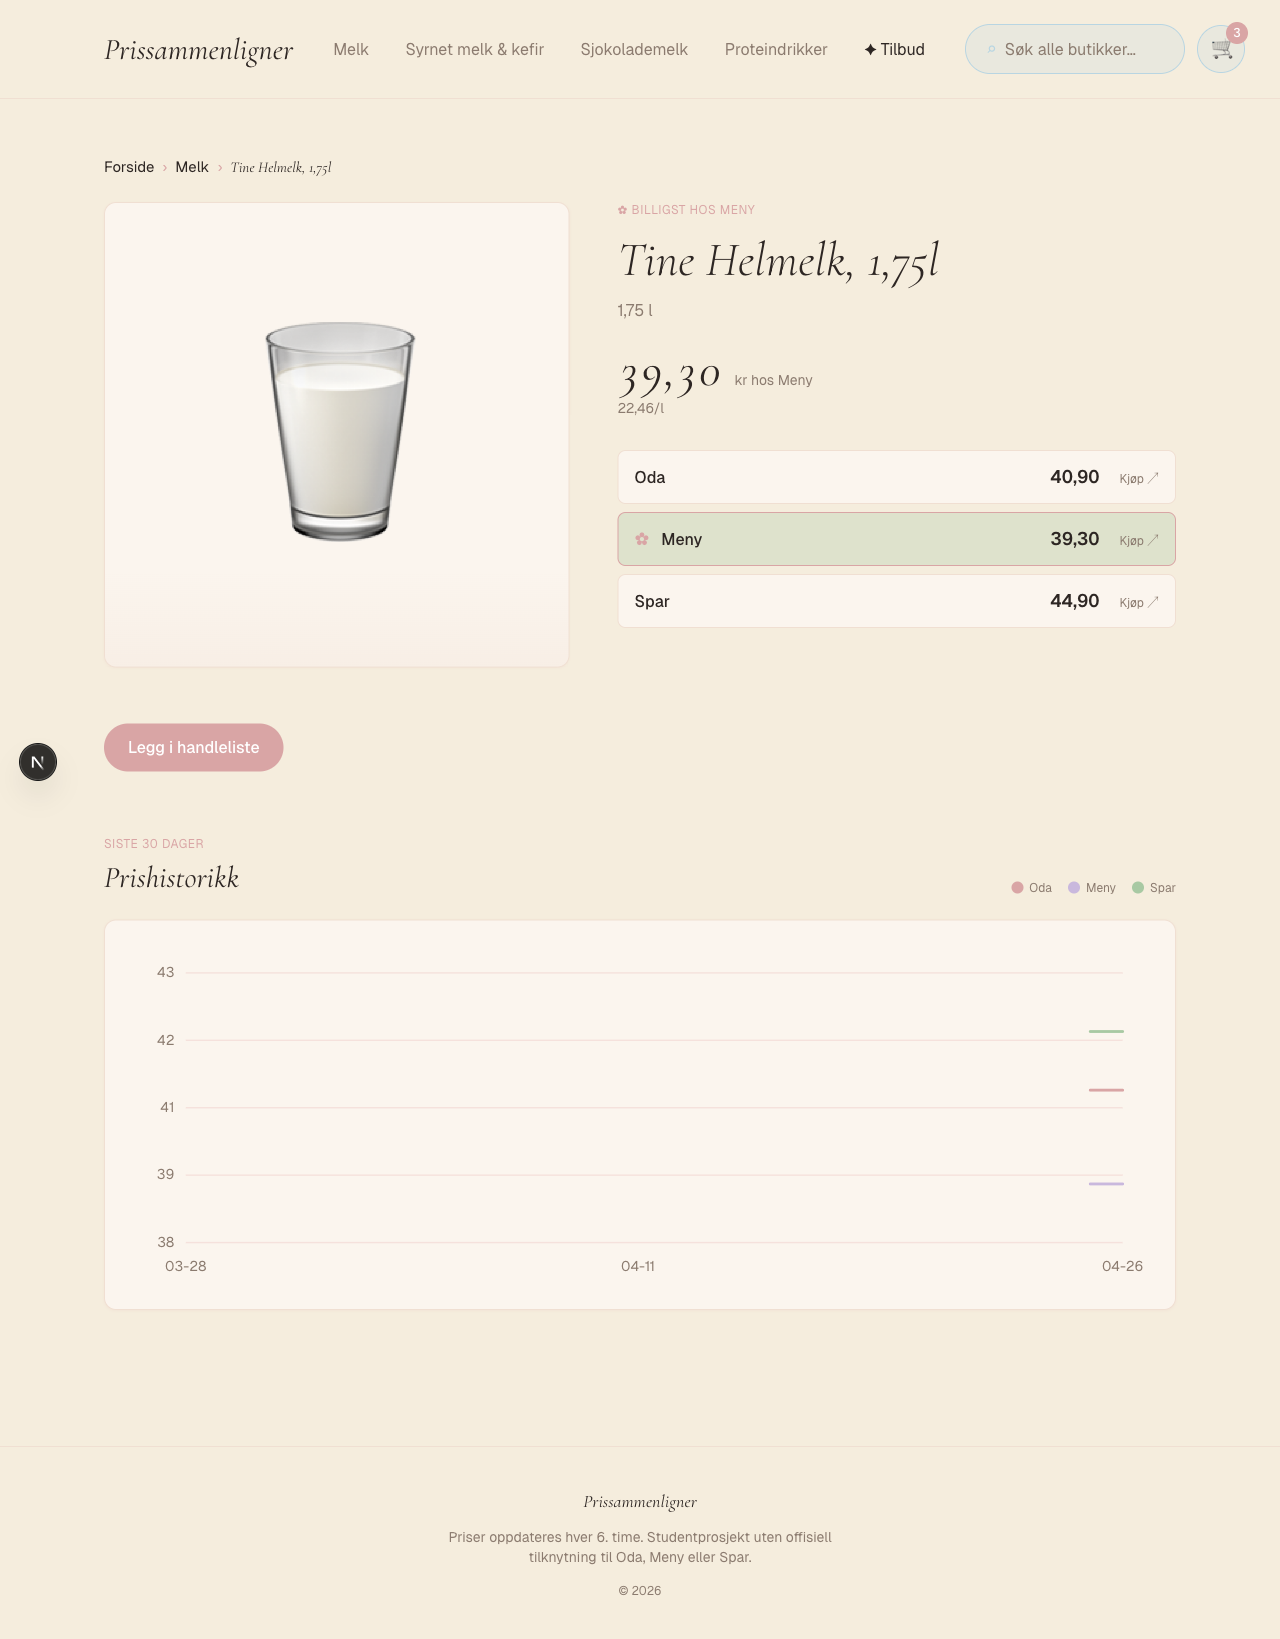
Tre Python-skrapere henter meieripriser fra Oda, Meny og Spar hver sjette time. De kjører som cron i GitHub Actions, og hvert kall lagrer én rad i price_snapshot-tabellen i Supabase Postgres. Frontend er bygd i Next.js App Router og leser direkte fra Postgres uten ORM, slik at jeg har full kontroll over SQL-en. Brukeren får kategori-side med pris-tabell på tvers av butikker, produkt-detalj med 30-dagers prishistorikk, søk, og en handleliste i localStorage som regner ut totalsum per butikk og foreslår den billigste.
Beslutninger og refleksjon
Beslutninger jeg tok
Rå SQL for full kontroll over hver spørring. En ORM som Prisma eller Drizzle ville lagt et abstrakt lag mellom meg og databasen. Jobben hos AVANTAS har gjort meg vant til SQL, og jeg ville se hva som faktisk traff databasen. Hver spørring står som template-literal i app/page.js og app/kategori/[slug]/page.js, så jeg kan kopiere den rett inn i Supabase SQL Editor for å feilsøke.
Snapshot-tabell ga prishistorikk gratis. price_snapshot lagrer én rad per scraping. Det enkleste hadde vært én "current price"-kolonne på listing som blir overskrevet for hver scraping, men da hadde jeg ingen historikk å vise. Grafen på produktsiden er MIN(COALESCE(campaign_price, price)) gruppert på dag, ingenting annet.
Lese __NEXT_DATA__ rett ut av HTML-en. Oda er en Next.js-app, så det fristet å treffe data-endepunktet _next/data/{BUILD_ID}/... direkte. Problemet er at BUILD_ID bytter hver gang Oda deployer, og scraperen ville knekt på hver eneste deploy. Jeg leser derfor <script id="__NEXT_DATA__"> ut av HTML-en og parser JSON-en derfra. Mer regex, men overlever deploys.
Normalisering via regex (scrapers/normalize.py) i stedet for fuzzy matching eller LLM-kall. "Tine Lettmelk 1 liter" hos Meny og "Lettmelk 0,5% fett, 1l" hos Oda skal matches til samme product-rad. Jeg fjerner generiske merker (tine, q, synnøve), stopwords (fett, melk), konverterer ml til liter, og bytter komma med punktum i tall. Levenshtein-distance eller LLM-kall ble for tungt for et hobbyprosjekt. Edge cases finnes, men løsningen er deterministisk og lett å debugge.
Cron via GitHub Actions i stedet for Vercel Cron eller Supabase Edge Functions. De serverless-alternativene koster eller har gratis-grenser jeg ikke vil tenke på. GitHub Actions er gratis for offentlige repoer og kjører Python uten ekstra oppsett. Cron-uttrykket 0 */6 * * * står i .github/workflows/scrape.yml.
Hva jeg lærte
Skraperne er fragile. Hvis Oda flytter strukturen i __NEXT_DATA__, eller Meny og Spar endrer kategori-API-et, knekker scraperen til jeg fikser regexen for hånd. Butikkene har ingen åpen API, så HTML-skraping ble den eneste veien inn. Konkret er det ikke skrevet en eneste test på normalize.py, og det er nettopp den regex-jungelen som mest fortjener dem.
«Hver 6. time» høres trygt ut til man ser hva som faktisk sviktet. Det er ingen retry-logikk i httpx-kallene, så hvis Oda svarer 503 én gang, hopper den scraperen over en kjøring uten varsling. På et hobbyprosjekt er det greit. En ekte driftssetting hadde trengt retry, et dead letter-sted for feilede kjøringer, og noe som faktisk varsler meg når det skjer.
Snapshot-modellen kostet lite å sette opp og ga prishistorikk på kjøpet, men spørringene mot price_snapshot blir dyrere etter hvert som radene hoper seg opp. På produktsiden må SQL-en hente siste snapshot per listing via en subquery på MAX(scraped_at), og det merkes med revalidate = 0 der ingenting caches. Jeg ville ikke gjort om snapshot-valget, men neste gang setter jeg opp et indeks-eksperiment før jeg har 50 000 rader å trekke fra.
Technology Stack
- Frontend:Next.js, React, Tailwind
- Database:Supabase, Postgres
- Skrapere:Python, httpx
- Infra:GitHub Actions, Vercel
Key Features
- Skrapere på cron
Tre Python-skrapere henter meieripriser fra Oda, Meny og Spar hver sjette time via GitHub Actions.
- Prishistorikk gratis
Hver scraping lagres som rad i price_snapshot, så produktsiden viser 30 dagers historikk uten ekstra logikk.
- Handleliste i nettleseren
Lokal kurv i localStorage regner ut totalsum per butikk og foreslår den billigste.


